Google Discover expérimente un bouton pour retenir vos lecteurs : les enjeux majeurs pour les éditeurs
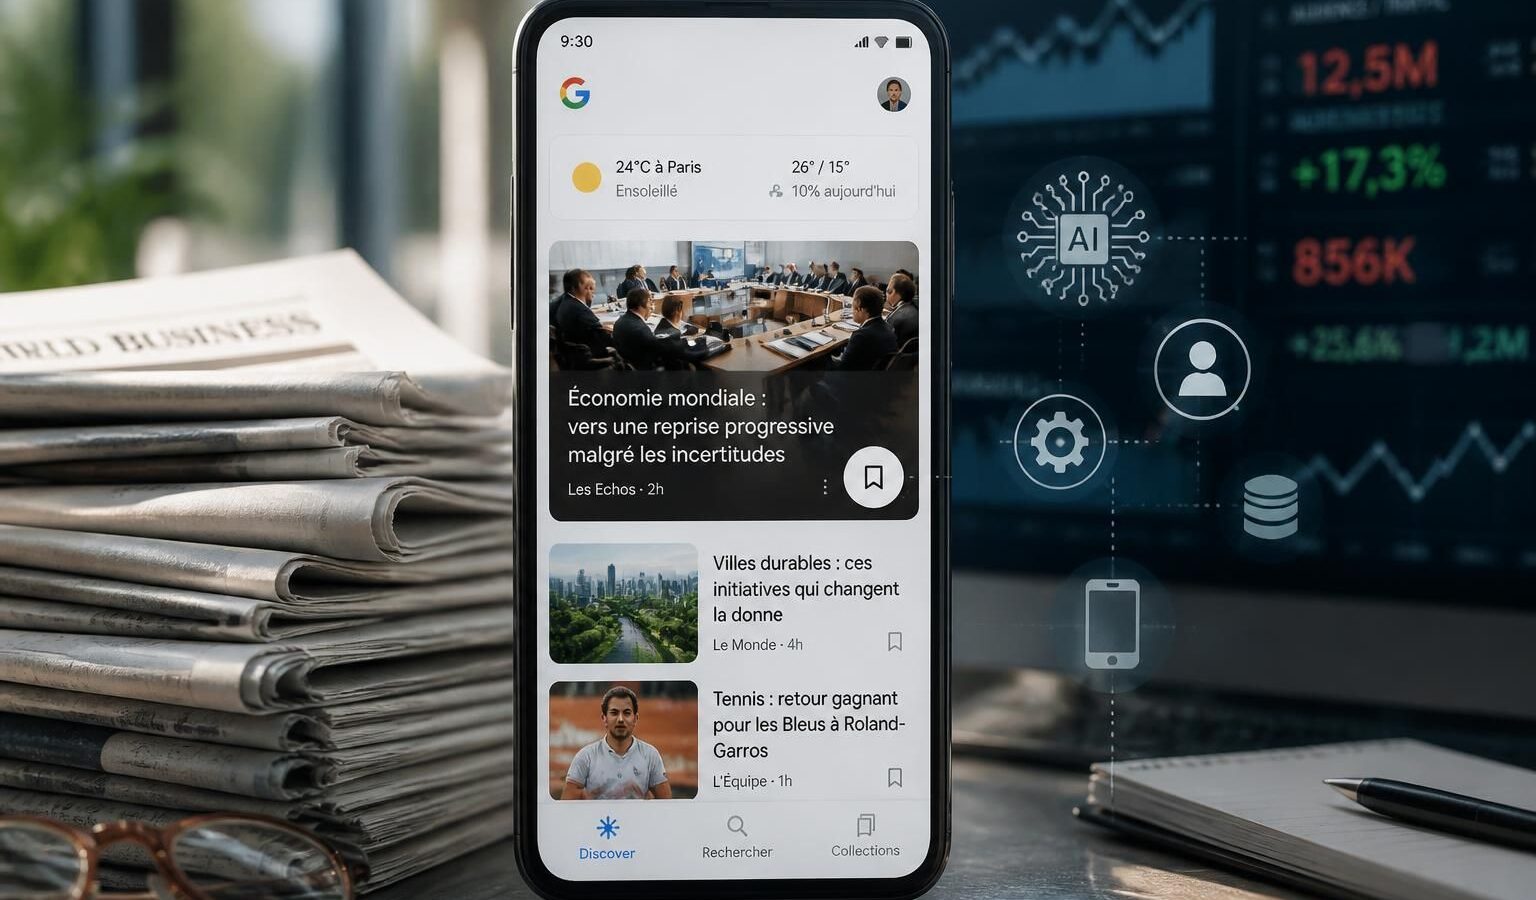
Google Discover expérimente Dive Deeper, un bouton ouvrant un résumé généré par intelligence artificielle avant plusieurs liens éditoriaux. Le test concerne notamment des cartes associées à des vidéos météo ou à des sujets d’actualité. Au lieu d’envoyer immédiatement l’utilisateur vers un article, l’interface développe le thème au sein de l’environnement Google, puis présente une sélection de sources. Ce parcours modifie la place accordée aux éditeurs de contenu : leurs publications alimentent l’exploration, tandis que le premier niveau de lecture reste contrôlé par la plateforme.
Cette évolution peut augmenter le temps passé dans Discover et rendre la consultation plus fluide. Elle expose aussi les médias à une diminution des visites, particulièrement lorsque le résumé répond déjà au besoin initial. Le risque varie selon la dépendance du site au flux, le type de requête informationnelle et la capacité des titres à susciter une lecture approfondie. Une stratégie numérique adaptée doit donc relier visibilité éditoriale, fidélisation lecteurs, mesure des clics et monétisation. Le bouton Dive Deeper doit par ailleurs être distingué de Preferred Sources, une autre fonction de Google permettant aux internautes de signaler leurs publications favorites.
En Bref
- Dive Deeper ouvre un aperçu produit par l’IA avant d’afficher des liens vers les publications associées au sujet.
- Le dispositif peut enrichir l’expérience utilisateur, mais aussi satisfaire certaines intentions sans visite sur le site source.
- Les éditeurs doivent mesurer séparément impressions, clics, engagement lecteur, inscriptions et revenus issus de Discover.
- Preferred Sources représente un levier complémentaire de fidélisation, car le lecteur peut déclarer explicitement ses sites favoris.
- La réponse éditoriale repose sur des contenus originaux, une identité reconnaissable et une relation directe avec l’audience.
Google Discover et Dive Deeper : comprendre le fonctionnement du bouton expérimental
Google Discover propose des contenus sans exiger la saisie préalable d’une requête. Le flux apparaît principalement dans l’application Google sur les appareils mobiles et dans certains espaces d’Android. Sa sélection dépend des centres d’intérêt estimés, de l’activité autorisée dans le compte et du contexte de consultation. Cette logique distingue Discover d’une page classique de résultats, même si les deux produits reposent sur des systèmes automatisés de classement.
Le bouton Dive Deeper ajoute une étape à ce parcours. Lorsqu’il accompagne une carte compatible, son activation affiche un développement thématique conçu par les systèmes d’intelligence artificielle de Google. Cet aperçu peut synthétiser plusieurs éléments, organiser les informations et présenter ensuite une rangée de liens. L’utilisateur reste donc dans l’interface avant de choisir une publication à consulter.
Un résumé IA placé avant les articles des éditeurs
La position du résumé constitue le principal changement. Une carte Discover traditionnelle valorise une image, un titre, le nom de la source et un lien. Dive Deeper intercale une réponse supplémentaire entre la recommandation et la visite. Cette couche peut faciliter la compréhension d’un sujet complexe, notamment lorsque plusieurs articles traitent d’un même événement sous des angles proches.
Pour un thème météorologique, l’aperçu peut rapprocher une vidéo, une explication générale et différents reportages. Sur un dossier technologique, il peut réunir les caractéristiques d’un produit, son contexte de lancement et les analyses de plusieurs publications. Les liens restent présents, mais leur visibilité dépend de la façon dont Google compose l’écran, de la longueur du résumé et de l’effort nécessaire pour atteindre les sources.
L’expérimentation ne signifie pas qu’un déploiement mondial est acquis. Google teste régulièrement des formats sur des groupes limités, puis ajuste ou abandonne certaines interfaces. Aucune méthode fiable ne permet à un éditeur de provoquer l’apparition de Dive Deeper sur une carte précise. Il faut donc observer le phénomène comme une évolution possible du parcours, sans reconstruire toute une production autour d’un format encore expérimental.
Une fonction différente du bouton Preferred Sources
Deux mécanismes peuvent facilement être confondus. Dive Deeper sert à approfondir un thème à partir d’un résumé automatisé. Preferred Sources permet, pour sa part, de sélectionner une publication favorite afin d’augmenter ses chances d’apparition dans certains espaces de Google Search. Le premier organise la découverte d’un sujet ; le second enregistre une préférence explicite envers une source.
Google affirme que les internautes sont deux fois plus susceptibles de cliquer sur une source qu’ils ont désignée comme préférée. L’entreprise a également indiqué que plus de 600 000 sources avaient déjà été sélectionnées dans ce cadre. Ces données proviennent de la communication de Google sur Preferred Sources et ne mesurent pas directement l’impact de Dive Deeper.
L’expression bouton retenue peut désigner la logique générale de ces interfaces, mais elle recouvre deux formes de rétention. Dive Deeper retient momentanément l’attention dans Google en enrichissant la carte. Preferred Sources aide un média à retenir une place dans les habitudes de recherche d’un lecteur. Une stratégie de fidélisation lecteurs doit traiter ces fonctions séparément afin d’éviter des objectifs et des indicateurs incompatibles.
Ce que Google peut utiliser pour personnaliser Discover
La personnalisation dépend des paramètres choisis par l’internaute. Google explique utiliser des cookies et des données, dont les adresses IP, pour fournir ses services, mesurer l’audience, prévenir la fraude et détecter les interruptions. Lorsque l’utilisateur accepte les finalités additionnelles, ces informations peuvent aussi contribuer à personnaliser les contenus, développer des services et mesurer l’efficacité publicitaire.
Un refus de ces finalités ne transforme pas le flux en sélection aléatoire. Le contenu non personnalisé peut encore dépendre de la page consultée, de la session de recherche active et de la localisation générale. L’âge peut également influer sur l’adaptation de l’expérience lorsque ce traitement s’applique. Ces paramètres expliquent pourquoi deux personnes ne voient pas nécessairement les mêmes cartes ni les mêmes fonctions expérimentales.
Pour les éditeurs, cette variabilité complique les tests manuels. Une capture d’écran isolée ne permet pas d’évaluer la couverture du dispositif, son pays de diffusion ou sa fréquence. Le suivi doit reposer sur des tendances agrégées dans les outils d’analyse, accompagnées d’observations réalisées sur plusieurs terminaux et profils autorisés. Cette méthode limite les interprétations fondées sur une seule apparition du bouton.
Trafic Google Discover : les risques de Dive Deeper pour les éditeurs de contenu
Discover peut représenter une source de trafic considérable pendant une période courte. Une publication bien distribuée reçoit parfois un volume rapide d’impressions, puis disparaît presque entièrement du flux lorsque l’intérêt évolue. Cette volatilité existait avant les résumés générés par IA. Dive Deeper ajoute une variable, puisque la visibilité d’une carte ne garantit plus que le premier geste mène vers le domaine de l’éditeur.
Le scénario le plus défavorable concerne les sujets dont la réponse tient en quelques lignes. Une date, un résultat, une caractéristique technique ou une alerte météo peuvent être compris depuis l’aperçu. Le besoin immédiat est alors satisfait sans ouverture de page. Les articles essentiellement fondés sur la reformulation d’une information publique deviennent plus exposés à cette forme de consultation sans clic.
Le déplacement du clic dans l’expérience utilisateur
Le clic ne disparaît pas nécessairement. Il intervient plus tard et dépend d’une motivation plus forte. Un lecteur peut ouvrir le résumé, parcourir les éléments proposés, puis sélectionner la source offrant l’analyse la plus identifiable. Ce filtre peut réduire le nombre total de sessions tout en orientant vers le site des visiteurs mieux informés et potentiellement plus intéressés.
Cette hypothèse doit être vérifiée par les données propres au média. Un trafic inférieur peut rester intéressant si le taux d’inscription, la durée de lecture ou le revenu par session progresse. À l’inverse, une baisse modérée des visites peut fragiliser un modèle reposant sur un grand volume d’impressions publicitaires. La conséquence financière dépend donc de la qualité des sessions perdues et de celles conservées.
Un site publiant des alertes très courtes présente un profil différent d’un magazine proposant des essais, des comparatifs et des enquêtes. Dans le premier cas, l’aperçu peut reprendre l’essentiel de la valeur informationnelle. Dans le second, un résumé ne remplace ni la méthodologie, ni les mesures détaillées, ni les documents originaux. La profondeur du travail éditorial devient un facteur de résistance aux réponses synthétiques.
Trois niveaux de dépendance à surveiller
La part de Discover dans l’acquisition doit être calculée sur plusieurs périodes. Une moyenne mensuelle peut masquer une forte concentration autour de quelques articles. Il convient également d’isoler les nouveaux visiteurs, car ils sont généralement plus sensibles aux changements d’interface que les abonnés revenant directement. Cette ventilation permet de distinguer un recul ponctuel d’une fragilité structurelle.
- Une dépendance faible correspond à un site dont les accès directs, les newsletters, les abonnements et la recherche classique dominent durablement l’audience.
- Une dépendance intermédiaire apparaît lorsque Discover accélère la diffusion de certains dossiers sans financer seul l’activité éditoriale.
- Une dépendance forte concerne les publications dont une part substantielle des pages vues et des revenus publicitaires provient de pics Discover.
- Une exposition critique combine trafic concentré, faible taux de retour, absence de comptes utilisateurs et contenus facilement résumables.
Cette classification n’exige aucun seuil universel. Un pure player financé par la publicité ne tolère pas la même baisse qu’un média spécialisé soutenu par les abonnements. Le coût de production compte aussi : perdre dix mille visites sur une brève automatisée n’a pas le même effet que sur une enquête ayant mobilisé plusieurs semaines de travail.
La visibilité sans visite reste difficile à valoriser
Une apparition dans un aperçu IA peut accroître la reconnaissance d’un nom de domaine. Cette exposition reste pourtant difficile à facturer et à relier à une conversion. Les outils traditionnels mesurent correctement la session arrivée sur le site, mais beaucoup moins l’influence d’une citation ou d’un lien simplement aperçu dans Discover. La valeur de marque existe, sans se substituer automatiquement aux revenus d’une page consultée.
Les éditeurs devraient documenter les situations où leur nom, leur image ou leur contenu sont repris dans le parcours. Des observations datées, des captures et une comparaison des pages concernées peuvent révéler des motifs. Cette démarche ne fournit pas les volumes globaux du test, mais elle aide les équipes éditoriales, SEO et commerciales à partager le même diagnostic.
Google précise dans sa documentation Search Central consacrée à Discover qu’aucune balise spéciale n’est requise pour être éligible. Une page indexée et conforme aux règles peut apparaître dans le flux, sans garantie de diffusion. Les images larges, les titres représentatifs et l’absence de procédés trompeurs restent des pratiques recommandées.
Le suivi doit éviter un raccourci fréquent : attribuer toute baisse au nouveau bouton. La saisonnalité, les changements d’intérêt, la concurrence, la fréquence de publication et les mises à jour de l’algorithme Google peuvent produire des variations comparables. Une analyse méthodique compare les pages, les thèmes, les formats et les périodes avant de retenir une cause opérationnelle.
Une vidéo de démonstration peut aider à comprendre la séquence des écrans, mais elle ne mesure pas l’exposition réelle d’un domaine. Les décisions d’investissement doivent rester fondées sur les données du site, les revenus associés et la stabilité des autres canaux d’acquisition.
Fidélisation lecteurs : construire une relation directe au-delà de Google Discover
Une audience provenant de Discover appartient d’abord à un environnement de recommandation. Le média ne choisit ni le moment d’affichage, ni le profil exact du destinataire, ni la durée de distribution de la carte. La fidélisation commence lorsque cette visite ponctuelle produit une action réutilisable : inscription, création de compte, ajout aux favoris, abonnement ou retour spontané vers le domaine.
Le premier objectif consiste à rendre la source identifiable. Un titre générique, une maquette interchangeable et une promesse éditoriale floue limitent la mémorisation. Le nom de la publication, son domaine d’expertise et la nature de son apport doivent apparaître avec cohérence. Cette cohérence concerne la carte, la page d’arrivée, les auteurs réels, les visuels et la manière de traiter un sujet.
Preferred Sources comme outil d’engagement lecteur
Le bouton Preferred Sources peut être intégré par les éditeurs sur leurs propres pages lorsque la fonctionnalité est disponible pour leur public. Son intérêt réside dans la simplicité de l’action. Le lecteur signale sa préférence à Google sans devoir chercher manuellement le réglage correspondant. Le média obtient alors une chance supplémentaire d’être repéré dans les espaces compatibles de Search.
Cette invitation doit rester contextuelle. Une demande placée avant le premier paragraphe risque d’interrompre la lecture et de dégrader l’expérience utilisateur. Un emplacement après un contenu utile, près d’une inscription à la newsletter ou dans l’espace réservé aux lecteurs réguliers offre une justification plus solide. Le message doit expliquer l’effet attendu sans promettre une apparition systématique.
Preferred Sources ne remplace pas une base de contacts consentie. Google contrôle toujours l’interface, les règles et l’éligibilité. Une adresse électronique collectée avec un accord clair permet au média d’envoyer une édition, de segmenter ses sujets et de mesurer les retours. Les deux leviers peuvent fonctionner ensemble, à condition d’éviter une accumulation de fenêtres et de boutons concurrents.
Transformer un pic Discover en relation récurrente
Une page issue du flux doit offrir une suite logique à la lecture. Sur un dossier consacré à une panne logicielle, le site peut proposer une chronologie mise à jour, une alerte thématique et un guide de résolution. Pour un lancement de smartphone, il peut relier la fiche technique, le test d’autonomie et la comparaison tarifaire. Ces parcours donnent une raison concrète de continuer sur le domaine.
Les recommandations internes gagnent à utiliser le contexte sémantique de l’article. Un carrousel automatique affichant seulement les contenus les plus récents produit souvent des associations faibles. Une sélection éditoriale de trois à cinq liens répond mieux aux intentions probables. Elle réduit également le nombre de choix, ce qui facilite la navigation sur un écran mobile.
La newsletter doit présenter une promesse précise. « Recevoir les actualités » renseigne peu sur la fréquence et le bénéfice. Une formulation indiquant le thème, le rythme et le type de contenu aide le lecteur à décider. Le double consentement, lorsqu’il est utilisé, améliore la qualité des adresses et fournit une confirmation explicite, même s’il ajoute une étape au parcours.
Des contenus moins faciles à remplacer par un aperçu
L’originalité ne repose pas sur la longueur seule. Un article de 2 000 mots peut rester entièrement dérivé d’informations disponibles ailleurs. À l’inverse, une publication plus courte peut apporter une mesure exclusive, un document, une photographie de terrain ou une méthode reproductible. Les aperçus automatisés savent condenser des faits ; ils remplacent moins facilement une preuve originale ou une expertise démontrée.
Les tests de produits illustrent cette différence. Reprendre une fiche constructeur expose fortement le contenu à la synthèse. Mesurer la luminosité, chronométrer une recharge, documenter le protocole et publier les résultats crée une contribution spécifique. Le lecteur peut comprendre le verdict dans Discover, puis ouvrir la page pour vérifier les données et comparer les conditions d’essai.
Le même principe vaut pour le marketing digital. Une publication expliquant qu’une campagne a progressé reste abstraite. Un cas documenté avec objectifs, canaux, créatifs, calendrier et limites apporte une méthode exploitable. Les éditeurs de contenu peuvent également publier leurs grilles d’évaluation, les corrections apportées après publication et les sources primaires utilisées.
Limiter les obstacles après le clic
La fidélisation échoue lorsque la page mobile est lente, instable ou saturée. Une publicité recouvrant le titre, une demande de notification immédiate et une bannière de consentement mal dimensionnée consomment l’espace disponible. Le visiteur venant de Discover n’a encore développé aucune habitude envers le site. Chaque interruption augmente la probabilité d’un retour rapide vers le flux.
Les Core Web Vitals fournissent un cadre technique utile. Google utilise notamment le Largest Contentful Paint, l’Interaction to Next Paint et le Cumulative Layout Shift pour caractériser plusieurs dimensions de l’expérience. Ces indicateurs ne garantissent pas une distribution dans Discover, mais ils aident à détecter les lenteurs et déplacements visuels qui pénalisent la consultation.
Une stratégie numérique robuste coordonne donc le produit, la rédaction, le SEO et la gestion des abonnements. L’équipe vérifie ce que voit le visiteur lors de sa première session, puis mesure les actions accomplies après la lecture. Le succès ne se limite plus à obtenir une carte ; il inclut la capacité du domaine à devenir une destination reconnue.
Mesure, engagement lecteur et monétisation : les indicateurs à suivre
Search Console fournit un rapport Discover lorsque le site atteint le seuil de données nécessaire. Ce rapport présente notamment les impressions, les clics et le taux de clics des contenus concernés. Il ne décrit pas chaque composant expérimental affiché avant la visite. Un éditeur ne peut donc pas isoler Dive Deeper avec un filtre natif si Google ne fournit aucun libellé dédié.
L’outil d’analyse du site prend le relais après le clic. Il mesure les pages vues, les événements, les conversions et les parcours internes selon la configuration adoptée. Les données doivent être rapprochées avec prudence, car Search Console et une solution analytique n’utilisent pas les mêmes méthodes ni les mêmes périmètres. Une correspondance parfaite entre leurs totaux n’est pas attendue.
Un tableau de bord adapté aux aperçus IA
Le tableau de bord devrait séparer la visibilité, l’acquisition, l’attention et la valeur économique. Cette hiérarchie évite de confondre une impression dans Discover avec une visite monétisable. Elle permet aussi d’identifier un scénario où le nombre de clics baisse alors que la qualité moyenne des sessions augmente.
| Dimension | Indicateur | Interprétation | Action possible |
|---|---|---|---|
| Visibilité | Impressions Discover | Présence des contenus dans le flux éligible | Comparer les thèmes, formats et périodes |
| Acquisition | Clics et taux de clics | Capacité d’une carte à provoquer une visite | Réviser titre, image et angle sans créer de promesse trompeuse |
| Attention | Temps engagé et profondeur de lecture | Intérêt réel après l’arrivée sur la page | Améliorer l’ouverture, la navigation et les contenus associés |
| Fidélisation | Inscriptions et retours directs | Transformation d’un visiteur ponctuel en audience récurrente | Clarifier les bénéfices du compte ou de la newsletter |
| Monétisation | Revenu par session et conversion payante | Valeur économique du trafic conservé | Ajuster formats publicitaires, offres et parcours d’abonnement |
Une lecture hebdomadaire suffit rarement pour les sites soumis à des pics d’actualité. Les équipes peuvent conserver un suivi quotidien opérationnel, puis réaliser une analyse sur quatre à huit semaines. Cette double temporalité distingue les incidents rapides des tendances durables. Les comparaisons doivent aussi tenir compte des jours de publication et de l’intensité informationnelle.
Mesurer la perte potentielle sans inventer de causalité
Aucun indicateur unique ne révèle combien de visites ont été absorbées par un résumé IA. Une méthode raisonnable consiste à créer des groupes de pages comparables : même rubrique, format voisin, niveau d’actualité similaire et ancienneté équivalente. Les variations d’impressions et de clics peuvent ensuite être examinées avec les changements de contenu, de concurrence et de distribution.
Les pages apportant une réponse brève forment un premier groupe. Les enquêtes, tests originaux et guides approfondis en constituent un second. Si le taux de clics recule davantage dans le premier ensemble, l’hypothèse d’une satisfaction directe dans l’interface gagne en crédibilité. Elle demeure une hypothèse tant que le produit ne fournit pas de données d’exposition spécifiques.
Les annotations internes améliorent l’analyse. Une équipe peut enregistrer la refonte d’un gabarit, le changement d’un titre, une panne de suivi, une campagne payante ou l’apparition observée de Dive Deeper. Sans cette chronologie, une baisse liée à un dysfonctionnement technique risque d’être attribuée à l’algorithme Google.
Protéger la monétisation sans surcharger les pages
La réponse immédiate à une baisse de trafic consiste parfois à augmenter le nombre de publicités. Cette décision peut réduire le revenu à moyen terme si elle dégrade la lecture, ralentit l’affichage ou pousse les visiteurs à partir. Le revenu par mille pages vues doit être analysé avec le revenu par session, la récence des visiteurs et leur probabilité de revenir.
Les abonnements, adhésions et produits dérivés offrent des revenus moins directement liés au volume de pages. Ils exigent toutefois une proposition éditoriale claire et un suivi régulier. Un média spécialisé peut réserver des bases de données, outils ou analyses approfondies à ses membres, tout en maintenant des articles accessibles capables de circuler dans Discover.
L’affiliation constitue une autre option pour les comparatifs et tests. Elle doit rester compatible avec l’indépendance éditoriale et les obligations de transparence. Les liens commerciaux ne compensent pas un contenu faible, car ils convertissent surtout lorsque le lecteur fait confiance au protocole et comprend les critères de sélection.
Les tutoriels consacrés au rapport Discover facilitent la prise en main des filtres par page, pays, date et type d’apparence disponible. Ils doivent être adaptés au plan de mesure du média, car une interface standard ne connaît ni les coûts de production ni les objectifs commerciaux propres à chaque publication.
Organiser un test éditorial exploitable
Un protocole simple peut comparer plusieurs familles de titres, d’images et d’ouvertures, sans modifier toutes les variables simultanément. Les pages doivent conserver une promesse fidèle au contenu. Un meilleur taux de clics obtenu par exagération produit souvent des retours rapides, un engagement faible et une perception négative de la marque.
La période de test doit couvrir assez de publications comparables. Un résultat fondé sur deux articles très différents n’aide pas à décider. Les équipes peuvent documenter la cible, l’hypothèse, le changement, l’indicateur principal et les effets secondaires. Cette discipline relie les choix éditoriaux à la monétisation sans réduire la qualité à un seul chiffre.
Algorithme Google, confidentialité et plan d’action pour les éditeurs
Discover s’appuie sur des systèmes de recommandation dont les détails complets ne sont pas publics. Google décrit des principes d’éligibilité et des bonnes pratiques, sans fournir une formule permettant de prévoir chaque apparition. La personnalisation ajoute une forte variabilité : un contenu peut être visible auprès d’un segment et absent chez un autre, même lorsque la page reste indexée.
Le lancement d’un aperçu IA ne justifie donc pas une recherche de recette secrète. Les ajustements durables concernent la qualité de la source, l’originalité, la présentation mobile et la relation avec le public. Les techniques visant à provoquer artificiellement le clic peuvent créer un gain bref, puis affaiblir la satisfaction et la confiance.
Intégrer la confidentialité à l’expérience utilisateur
Google indique que ses services utilisent des cookies et certaines données pour maintenir les fonctionnalités, suivre les interruptions, prévenir les abus et mesurer l’audience. Les traitements additionnels liés à la personnalisation et à la publicité dépendent des choix présentés à l’utilisateur. Des réglages complémentaires restent accessibles depuis les outils de confidentialité du compte.
Les éditeurs doivent appliquer la même clarté sur leurs propres domaines. Le bandeau de consentement doit différencier les finalités, enregistrer le choix et rester utilisable sur mobile. Un refus ne devrait pas rendre l’article illisible lorsque les traitements concernés ne sont pas nécessaires à sa fourniture. Cette cohérence réduit les frictions après l’arrivée depuis Discover.
Les données d’engagement ne doivent pas être accumulées sans objectif. Chaque événement analytique devrait répondre à une décision possible : améliorer un module, évaluer une inscription ou comprendre un abandon. Une collecte moins dispersée facilite les contrôles, la documentation et l’analyse. Elle limite également les tableaux de bord remplis d’indicateurs jamais utilisés.
Un plan opérationnel en plusieurs étapes
- Mesurer la part de Google Discover dans les clics, les nouveaux visiteurs, les revenus publicitaires et les inscriptions sur plusieurs périodes.
- Identifier les contenus faciles à résumer, puis renforcer leur apport avec des données, documents, observations ou méthodes propres à la rédaction.
- Vérifier les pages mobiles, le poids des images, la stabilité visuelle, les publicités et les demandes de consentement.
- Déployer des parcours de fidélisation sobres : newsletter thématique, compte, alertes choisies, favoris et Preferred Sources lorsque disponible.
- Créer des annotations pour les changements de gabarit, les incidents, les campagnes et les observations relatives à Dive Deeper.
- Diversifier l’acquisition avec la recherche classique, l’accès direct, les éditions électroniques, les communautés et les partenariats.
- Relier chaque expérimentation à un indicateur principal et à une durée d’observation définie.
La diversification ne consiste pas à publier partout de manière identique. Chaque canal possède son usage. Une newsletter favorise un rendez-vous régulier, une communauté facilite les échanges, Search répond à une intention formulée et Discover stimule une découverte passive. Le contenu peut conserver le même socle tout en adaptant son format et son appel à l’action.
Répartir les responsabilités dans la rédaction numérique
L’équipe éditoriale définit l’angle, vérifie les informations et produit les éléments originaux. Le pôle SEO contrôle l’indexation, les titres, les images et les performances par sujet. Les responsables produit améliorent le parcours mobile, tandis que l’analytique construit les segments et vérifie le marquage. Les services commerciaux évaluent enfin les effets sur les revenus et les abonnements.
Une réunion courte et régulière peut réunir ces observations sans transformer chaque fluctuation en urgence. Le tableau partagé doit présenter les changements significatifs, les pages concernées et les hypothèses testables. Une baisse globale ne nécessite pas la même réponse qu’un recul limité aux brèves, à un pays ou à un type d’appareil.
La veille produit reste utile, car Google peut modifier le nom, la disposition ou le périmètre de l’expérience. Elle doit s’appuyer sur des annonces officielles, des observations reproductibles et les données internes. Les captures publiées sur les réseaux sociaux montrent une interface possible, mais rarement sa fréquence, son audience ou son influence économique.
Préparer plusieurs scénarios de déploiement
Un premier scénario prévoit l’arrêt du test. Les investissements réalisés doivent alors rester utiles : meilleures pages mobiles, contenus plus originaux et audience directe. Un deuxième envisage un déploiement limité à certains formats. L’analyse par rubrique permettra d’orienter les ressources vers les catégories les plus touchées.
Un troisième scénario suppose une généralisation des aperçus IA. Les publications capables de démontrer leur provenance, de proposer des outils et de convertir les visiteurs conserveront davantage de leviers. La priorité portera sur la valeur ajoutée après le résumé : preuves, contexte, visualisations, bases documentaires, mises à jour et services réservés.
Le marketing digital peut soutenir cette adaptation par des campagnes de réactivation, des offres d’essai et des segments fondés sur un consentement valide. Il ne corrigera pas une proposition éditoriale interchangeable. Les budgets doivent accompagner les contenus capables de susciter un usage régulier, avec un coût d’acquisition comparé à la valeur produite sur la durée.
On en dit Quoi ?
Le test Dive Deeper matérialise une évolution déjà visible dans la recherche : Google cherche à fournir davantage d’informations avant la visite d’un site. Les éditeurs ne disposent ni d’un réglage confirmé pour exclure spécifiquement leurs pages, ni de chiffres publics permettant d’estimer l’impact général du bouton. Leur marge d’action se situe dans la mesure de leur dépendance, l’amélioration de la valeur éditoriale et la création de relations directes. Preferred Sources apporte un outil complémentaire, mais il reste dépendant de l’écosystème Google. Les investissements les plus rationnels sont ceux qui améliorent aussi le site lorsque l’expérience change ou disparaît.
Questions pratiques sur Google Discover et Dive Deeper
Dive Deeper remplace-t-il les liens vers les éditeurs ?
Le format observé conserve des liens vers différentes sources, mais il insère un résumé généré par IA avant leur ouverture. Cette étape peut satisfaire certaines intentions sans visite ou, au contraire, aider un lecteur à choisir une source pour approfondir le sujet.
Un éditeur peut-il désactiver Dive Deeper pour son site ?
Aucun mécanisme public spécifique à Dive Deeper n’est établi dans les informations disponibles sur le test. Les éditeurs doivent suivre la documentation de Google, contrôler les usages autorisés de leurs contenus et mesurer les variations dans Search Console ainsi que dans leur outil analytique.
Dive Deeper et Preferred Sources désignent-ils le même bouton ?
Non. Dive Deeper développe un sujet avec un aperçu automatisé et plusieurs liens. Preferred Sources permet à un internaute d’indiquer qu’il souhaite voir davantage une publication dans certains espaces de Google Search.
Quels contenus résistent le mieux aux résumés IA ?
Les enquêtes, mesures originales, tests documentés, bases de données, outils interactifs, entretiens et analyses fondées sur des documents exclusifs offrent une valeur difficile à reproduire dans un aperçu bref. Leur méthode et leurs preuves doivent rester visibles sur la page.
Quels indicateurs faut-il surveiller en priorité ?
Les impressions et clics Discover doivent être rapprochés du taux d’engagement, des inscriptions, des retours directs, du revenu par session et des conversions payantes. Cette lecture évite d’évaluer la performance uniquement par le volume de visites.
Articles liés
Social Media
Découvrez la signification surprenante de l’expression “ça give” qui envahit les réseaux sociaux
Le verbe anglais « give » comporte quatre lettres et se traduit couramment par « donner » en français. Sur…
Social Media
OpenAI expérimente les agents sponsorisés : une révolution publicitaire conversationnelle dans ChatGPT
Le 16 septembre 2026, OpenAI a annoncé le test américain de ses premiers agents sponsorisés dans ChatGPT. Ce format permet…
Social Media
Meta One : tout comprendre sur le nouvel abonnement payant unifiant WhatsApp, Facebook et Instagram
Meta a annoncé le mardi 15 septembre 2026 le déploiement mondial de Meta One, son service regroupant plus de 50…