Outils IA pour créer et publier des contenus géolocalisés dans les sources référencées
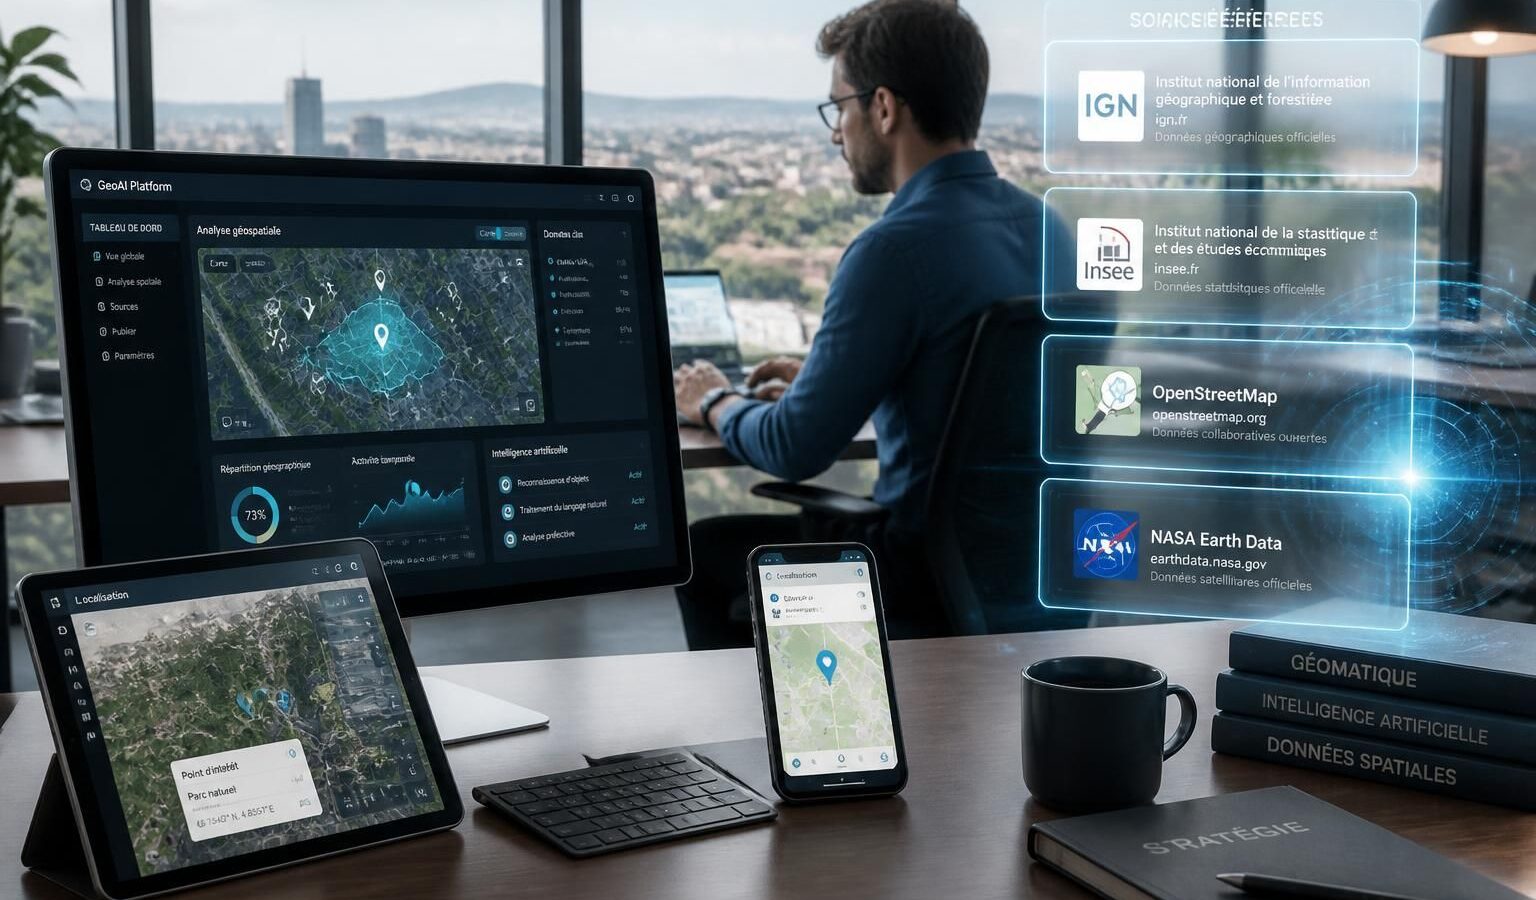
Le standard Schema.org décrit les coordonnées géographiques avec deux propriétés distinctes, latitude et longitude, exploitables par les machines. Cette précision technique résume le défi des contenus géolocalisés : associer un texte utile à des données locales compréhensibles par les moteurs de recherche, les assistants conversationnels et les plateformes cartographiques. L’intelligence artificielle accélère la recherche, la rédaction, la traduction et la publication de contenus, mais elle ne garantit ni l’exactitude d’une adresse ni la présence dans les sources référencées.
Une stratégie efficace repose sur des pages locales différenciées, des informations vérifiables et une architecture éditoriale cohérente. Les outils IA interviennent à plusieurs niveaux : analyse de données, recherche documentaire, génération de brouillons, adaptation linguistique, contrôle des citations et suivi du référencement. Ils doivent fonctionner avec un CMS, un système de validation humaine et des référentiels stables. Cette organisation évite la production massive de pages presque identiques, souvent peu utiles pour les internautes et difficiles à maintenir.
En Bref
- ChatGPT, Gemini, Perplexity et DeepL facilitent la recherche, la rédaction et l’adaptation locale des contenus.
- Semrush, Ahrefs, BrightLocal et Localo apportent des données sur les requêtes, les concurrents et la visibilité locale.
- Une page géolocalisée doit reposer sur une adresse, une zone desservie, des coordonnées et des sources contrôlées.
- Les balises hreflang, les données structurées et Google Business Profile renforcent la cohérence entre les différents canaux.
- La publication de contenus exige une validation humaine avant toute diffusion automatisée à grande échelle.
Stratégie GEO : préparer des contenus géolocalisés fiables et citables
La création de contenu local commence par la définition d’une unité géographique pertinente. Une entreprise peut travailler à l’échelle d’un pays, d’une région, d’une métropole, d’une commune ou d’un quartier. Ce choix dépend de ses points de vente, de ses zones de livraison et du vocabulaire utilisé par ses clients. Une page consacrée à une ville ne répond pas aux mêmes attentes qu’une fiche liée à un établissement précis.
Les informations fondamentales doivent provenir d’un référentiel interne validé. Celui-ci rassemble le nom commercial, l’adresse postale, le numéro de téléphone, les horaires, les coordonnées, les services disponibles et les restrictions locales. Le code de langue BCP 47, comme fr-FR ou fr-CA, peut compléter chaque enregistrement. Les codes de pays ISO 3166 facilitent également la normalisation des bases internationales.
Construire une base locale avant d’utiliser les outils IA
Un modèle génératif ne doit pas devenir la base de référence d’une adresse ou d’un horaire. Ces données évoluent et peuvent être reproduites avec des erreurs. Le système éditorial gagne donc à séparer les faits structurés du texte généré. Les champs validés alimentent ensuite les pages, les cartes, les fiches d’établissement et les réponses destinées au service client.
Un réseau de centres de formation peut, par exemple, conserver ses établissements dans un fichier maître ou un outil de gestion dédié. Chaque ligne contient un identifiant unique, une adresse normalisée, un point géographique et une liste de formations. L’intelligence artificielle reçoit seulement les champs nécessaires pour rédiger une présentation locale. Elle ne modifie jamais directement les coordonnées officielles.
La recherche éditoriale complète ce socle. Les requêtes associées à un territoire révèlent souvent des besoins concrets : temps de trajet, stationnement, accessibilité, livraison, réglementation régionale ou disponibilité d’un service. Une analyse de données issue de la Search Console, d’un outil SEO et du support client aide à classer ces attentes. Les sujets retenus doivent correspondre à un service réellement proposé.
Organiser les sources référencées et les preuves locales
Une source référencée possède une origine identifiable et une stabilité suffisante. Les sites institutionnels, bases publiques, documents réglementaires, pages officielles d’un établissement et publications professionnelles peuvent remplir ce rôle. Une URL seule reste insuffisante si son contenu ne confirme pas précisément l’affirmation utilisée. La date de consultation et le passage pertinent peuvent être conservés dans l’outil éditorial.
Les assistants tels que Perplexity ou Gemini accélèrent l’exploration documentaire. Leurs réponses servent à identifier des pistes, jamais à remplacer la lecture des documents. Chaque fait sensible doit être comparé avec la page d’origine. Cette vérification concerne notamment les tarifs publics, les règles administratives, les statistiques territoriales et les dates d’événements.
- Définir une zone géographique adaptée au service proposé.
- Centraliser les adresses et coordonnées dans un référentiel validé.
- Associer chaque affirmation locale à une source identifiable.
- Distinguer les données officielles des formulations produites par IA.
- Prévoir une fréquence de contrôle pour les horaires et services.
- Conserver un historique des corrections apportées aux pages.
La structure du contenu influence aussi sa capacité à être reprise par un moteur génératif. Un titre descriptif, des paragraphes centrés sur une seule idée et des tableaux correctement libellés facilitent l’extraction. Les réponses importantes doivent apparaître dans un contexte suffisant. Une phrase isolée contenant un chiffre sans unité, période ou territoire reste difficile à interpréter.
Google Search Central recommande d’utiliser hreflang pour indiquer les variantes linguistiques ou régionales d’une page. Cette annotation ne remplace pas une adaptation éditoriale réelle. Une page fr-FR et une page fr-CA peuvent partager une base commune, tout en différant sur les unités, les termes commerciaux, les coordonnées de contact et les modalités de livraison.
Le dispositif initial doit donc produire un ensemble contrôlable : données locales, sources, règles linguistiques et critères de validation. Cette base réduit les erreurs lors de la génération et permet de publier plusieurs variantes sans perdre la cohérence des informations opérationnelles.
Comparatif des outils IA pour la création de contenu local
Les outils IA ne couvrent pas tous la même étape de production. Certains génèrent des textes, d’autres recherchent des documents ou mesurent une visibilité locale. Une sélection cohérente assemble plusieurs briques au lieu de demander à une seule plateforme de tout traiter. Le choix dépend du volume de pages, du nombre de langues et des systèmes déjà utilisés par l’organisation.
ChatGPT, Gemini, Perplexity et DeepL pour produire et adapter
ChatGPT convient à la préparation de plans, à la transformation de données structurées en brouillons et à la création de variantes. Des instructions fixes peuvent imposer un ton, une longueur, une terminologie et des champs obligatoires. Les données sensibles exigent un cadre de gouvernance adapté au compte utilisé. Une sortie doit toujours être relue avant sa publication.
Gemini s’intègre à l’écosystème Google et peut assister la recherche ou la rédaction dans des environnements de travail compatibles. Son intérêt augmente lorsque les équipes gèrent déjà leurs documents dans cet écosystème. Il reste nécessaire de comparer toute information locale avec sa source d’origine. Une intégration pratique ne constitue pas une validation factuelle.
Perplexity met l’accent sur la recherche assistée et présente des liens associés aux réponses. Cette approche simplifie la constitution d’un premier dossier documentaire sur une ville ou une réglementation. Le rédacteur doit ouvrir chaque référence et contrôler qu’elle soutient bien le passage concerné. Les résumés générés peuvent omettre une exception ou une limite territoriale.
DeepL apporte une traduction et des fonctions de reformulation utiles aux contenus multilingues. Une traduction correcte sur le plan grammatical peut rester inadaptée au marché visé. Les noms de services, les unités, les mentions réglementaires et les expressions de recherche doivent faire l’objet d’une localisation. Une relecture par une personne familière du territoire conserve donc une fonction précise.
Semrush, Ahrefs, BrightLocal et Localo pour le référencement géographique
Semrush et Ahrefs analysent les mots-clés, les pages concurrentes, les liens et différents signaux de visibilité. Ils permettent de comparer le potentiel d’une requête nationale avec celui d’une expression comprenant un nom de ville. Les volumes affichés restent des estimations. Ils doivent être rapprochés des données internes, des conversions et des requêtes réellement observées.
BrightLocal se concentre sur le référencement local, notamment le suivi des positions géographiques, les citations locales et la réputation. Les rapports en grille peuvent montrer qu’un établissement apparaît près de son adresse, mais perd en visibilité à quelques kilomètres. Cette lecture spatiale aide à distinguer un problème de pertinence d’une simple limite de proximité.
Localo accompagne l’optimisation des fiches d’établissement et le suivi de leur présence locale. L’outil sert à structurer les tâches, surveiller certains concurrents et maintenir les informations utiles. Il ne remplace pas les règles de Google Business Profile. Les catégories, horaires et services publiés doivent rester conformes à l’activité constatée sur place.
| Outil | Usage principal | Apport géolocalisé | Contrôle nécessaire |
|---|---|---|---|
| ChatGPT | Rédaction et transformation | Création de variantes par ville | Exactitude des faits et ton local |
| Gemini | Recherche et assistance rédactionnelle | Exploitation de documents de travail | Vérification des références |
| Perplexity | Recherche avec liens | Repérage de sources territoriales | Lecture des pages originales |
| DeepL | Traduction et reformulation | Adaptation linguistique régionale | Terminologie et réglementation |
| Semrush | Analyse SEO | Étude des requêtes locales | Comparaison avec les données internes |
| Ahrefs | Contenus, liens et mots-clés | Analyse des pages locales concurrentes | Interprétation des estimations |
| BrightLocal | Suivi du SEO local | Mesure par zone géographique | Configuration des points de mesure |
| Localo | Gestion de présence locale | Optimisation des fiches d’établissement | Conformité des informations publiées |
| WordPress | Gestion et publication de contenus | Modèles de pages par territoire | Qualité des extensions et des données |
WordPress n’est pas un outil d’intelligence artificielle à lui seul, mais il joue souvent le rôle de centre de publication. Son API REST, ses champs personnalisés et ses extensions permettent d’injecter des informations locales dans des modèles contrôlés. Un système bien configuré sépare le texte éditorial, les coordonnées, les horaires et les métadonnées SEO.
Le choix final peut être effectué avec une grille pondérée. La qualité des sorties, la gestion des sources, les possibilités d’export, la sécurité et le coût doivent recevoir un poids distinct. Un test mené sur quelques zones contrastées révèle davantage de défauts qu’une démonstration limitée à une seule ville. La combinaison retenue doit préserver la traçabilité entre la donnée d’origine et la page publiée.
Une démonstration vidéo aide à visualiser les interfaces, mais les fonctionnalités et les offres commerciales peuvent évoluer. Les pages officielles des éditeurs restent la référence pour comparer les intégrations disponibles, les limites d’usage et les conditions de traitement des données.
Workflow IA pour créer des pages locales uniques et vérifiées
Un workflow éditorial robuste sépare la collecte, la rédaction, la validation et la publication de contenus. Chaque phase possède des entrées, un responsable et des critères de sortie. Cette méthode facilite les corrections lorsque plusieurs centaines de pages partagent le même modèle. Elle empêche également une modification automatique de se propager sans contrôle sur tous les territoires.
Transformer les données locales en briefs exploitables
La première étape consiste à nettoyer les données. Les adresses suivent un format commun, les numéros utilisent une convention stable et les horaires distinguent les jours habituels des exceptions. Les coordonnées sont exprimées dans le même système. Les doublons d’établissement doivent être éliminés avant la génération, faute de quoi plusieurs pages risquent de cibler une adresse identique.
Chaque brief peut contenir un identifiant local, une audience, une intention de recherche et les faits autorisés. Il précise aussi les formulations interdites, comme une promesse de disponibilité non confirmée. Les liens vers les sources référencées accompagnent les données. Le modèle reçoit donc un cadre fermé pour les éléments factuels, tout en conservant une marge sur la formulation.
Pour un réseau de magasins, le brief d’une page peut mentionner les produits réellement disponibles, les services sur place et les moyens d’accès validés. Le prompt demande ensuite une présentation, un bloc pratique et des réponses courtes aux besoins locaux. Une autre ville reçoit un ensemble différent. Le changement ne porte donc pas seulement sur le nom de la commune.
Rédiger avec des modèles de prompts contrôlés
Un prompt de production doit définir le rôle du texte, son public et sa source de vérité. Il indique les champs qui peuvent être reformulés et ceux qui doivent être reproduits sans modification. Un format de sortie structuré réduit le travail d’intégration. JSON peut servir d’intermédiaire technique, tandis que le CMS transforme ensuite les champs validés en HTML.
La consigne peut exiger une phrase courte par information pratique, un vocabulaire spécifique au secteur et l’absence de données non fournies. Elle peut aussi demander une liste des affirmations à vérifier. Cette sortie de contrôle ne doit pas être publiée. Elle sert au rédacteur pour repérer les passages où le modèle a extrapolé.
- Importer les établissements depuis le référentiel officiel.
- Normaliser les adresses, langues, horaires et coordonnées.
- Associer les requêtes locales à chaque type de page.
- Générer un brouillon à partir des seuls champs autorisés.
- Comparer les affirmations avec les documents sources.
- Contrôler les similarités entre les différentes pages.
- Valider le rendu dans l’environnement de préproduction.
- Publier par lots limités et surveiller les anomalies.
Le contrôle de similarité occupe une place importante. Des pages qui ne changent que le nom de ville offrent peu d’information spécifique. Un script peut comparer les textes et signaler les blocs trop proches. Le rédacteur enrichit alors les contenus avec des accès, des contraintes, des services ou des références territoriales utiles, sans inventer d’éléments décoratifs.
Mettre en place une validation éditoriale et technique
La vérification factuelle porte sur les noms, chiffres, adresses, liens et horaires. La relecture éditoriale examine la clarté, la tonalité et la pertinence locale. Le contrôle technique inspecte les balises, les liens canoniques, hreflang et les données structurées. Ces opérations peuvent être distribuées entre plusieurs profils, avec un statut enregistré dans le CMS.
Les données structurées utilisent le vocabulaire Schema.org. Le type LocalBusiness et ses variantes permettent de décrire un établissement, tandis que GeoCoordinates contient la latitude et la longitude. Le balisage doit correspondre au contenu visible de la page. Ajouter une propriété absente du texte ou incorrecte dans la réalité fragilise la cohérence documentaire.
Un environnement de préproduction permet de tester les modèles avant l’indexation. Les équipes y vérifient l’affichage mobile, les cartes, les boutons d’appel et les formulaires. Les liens externes sont également contrôlés. Une erreur de paramètre dans une URL cartographique peut diriger l’utilisateur vers un autre établissement malgré une adresse correcte à l’écran.
La publication progressive limite les risques. Un premier lot couvre quelques lieux représentatifs : grande ville, zone rurale, marché multilingue et établissement aux horaires particuliers. Les retours servent à corriger le modèle avant le déploiement général. Le journal de publication conserve la version du prompt, les données utilisées et l’identité du validateur.
Ce workflow attribue une fonction précise à chaque technologie. Le modèle produit une formulation, le référentiel fournit les faits, le CMS gère les versions et l’équipe autorise la diffusion. Cette séparation permet de corriger une information locale sans régénérer arbitrairement l’ensemble du texte.
Publication de contenus, géolocalisation et protection des données
La publication de contenus locaux implique souvent des données liées à la position. Une adresse d’établissement est destinée à être publique, tandis que la position précise d’un utilisateur relève d’un autre traitement. Cette différence doit apparaître dans l’architecture technique. Le site peut afficher des points de vente sans collecter automatiquement la localisation du visiteur.
Publier dans le CMS et les plateformes locales
Le CMS reçoit les textes validés, les champs géographiques et les métadonnées. Chaque page dispose d’une URL stable, d’un titre propre et d’un lien canonique cohérent. Les variantes linguistiques sont reliées par hreflang lorsqu’elles possèdent des équivalents réels. Une page traduite ne doit pas pointer vers une autre région sans correspondance éditoriale.
Google Business Profile complète le site pour les établissements accueillant une clientèle ou desservant une zone admissible. Le nom, la catégorie, les horaires et l’adresse doivent rester cohérents avec les informations publiques. Les publications locales peuvent relayer une nouveauté ou un changement de service. Elles ne remplacent pas une page durable sur le domaine officiel.
Les annuaires sectoriels, cartes et plateformes sociales forment d’autres points de diffusion. Une synchronisation mal préparée propage rapidement une erreur. Le référentiel central doit donc identifier la source prioritaire et le statut de chaque canal. Lorsqu’une adresse change, l’ordre de mise à jour peut être planifié afin de réduire les divergences temporaires.
Utiliser la position sans collecte excessive
Une interface peut demander l’autorisation du navigateur pour proposer l’établissement le plus proche. Ce consentement doit être compréhensible et lié à une fonction précise. Une alternative manuelle, comme la saisie d’un code postal, évite de bloquer les personnes qui refusent la géolocalisation. La précision demandée doit correspondre au besoin réel du service.
Les adresses IP peuvent participer à une estimation générale de la zone, à la sécurité et à la mesure d’audience. Google indique notamment utiliser des cookies et des données, dont les adresses IP, pour fournir ses services, mesurer l’engagement, protéger contre les abus et personnaliser certaines expériences selon les choix de l’utilisateur. Les réglages de consentement influencent donc les traitements supplémentaires.
La CNIL considère qu’une adresse IP peut constituer une donnée personnelle lorsqu’elle permet d’identifier directement ou indirectement une personne. Une organisation doit documenter sa finalité, sa base juridique, sa durée de conservation et ses destinataires. Les journaux techniques ne doivent pas être réutilisés librement pour enrichir des profils marketing sans cadre approprié.
Les outils de marketing digital ajoutent parfois des identifiants publicitaires, des historiques de navigation et des segments locaux. Leur activation doit respecter les choix exprimés dans l’interface de consentement. Un refus ne devrait pas empêcher l’accès aux informations essentielles d’une agence ou d’un magasin. Les contenus non personnalisés peuvent rester contextualisés selon la page consultée et une zone générale.
Automatiser la diffusion sans perdre la maîtrise
Les API permettent de publier depuis un outil central vers plusieurs destinations. Une file d’attente peut limiter le débit, enregistrer les erreurs et relancer seulement les éléments échoués. Chaque mise à jour reçoit un identifiant. Cette mécanique évite qu’une coupure réseau produise des doublons ou laisse une partie du parc avec des horaires obsolètes.
Les droits d’accès doivent refléter les responsabilités. Un modèle génératif peut créer un brouillon, mais il ne devrait pas disposer seul d’un droit de mise en ligne global. Le CMS peut imposer une approbation pour les modifications d’adresse, de téléphone ou de mentions légales. Les changements mineurs suivent un circuit plus léger, selon une matrice de risque définie.
La surveillance après publication contrôle les codes HTTP, les pages orphelines et la présence des champs essentiels. Elle peut détecter une carte indisponible, une image absente ou une donnée structurée invalide. Les alertes gagnent à être classées par gravité. Une adresse erronée exige un traitement plus rapide qu’une différence mineure de mise en forme.
Les tutoriels consacrés aux fiches locales illustrent les réglages courants et les méthodes de contrôle. Les règles officielles de la plateforme doivent rester prioritaires, notamment pour l’éligibilité des établissements, la représentation du nom et l’usage des zones desservies.
La gouvernance relie finalement les objectifs éditoriaux aux traitements techniques. Elle précise quelles données sont publiques, lesquelles demandent un consentement et qui peut modifier chaque champ. Ce cadre permet d’utiliser la géolocalisation dans la publication sans transformer une fonction de proximité en collecte disproportionnée.
Mesurer le référencement GEO et la présence dans les sources référencées
Le nombre de pages publiées ne mesure pas la qualité d’une stratégie locale. L’évaluation doit relier visibilité, exactitude et actions utiles. Une page peut recevoir peu de visites tout en générant des appels qualifiés. À l’inverse, un texte largement consulté peut attirer des internautes situés hors de la zone desservie et produire peu de valeur opérationnelle.
Définir des indicateurs par territoire et par intention
Les mesures SEO classiques restent pertinentes : impressions, clics, position moyenne, pages indexées et requêtes. Elles doivent être segmentées par type d’établissement, langue et zone. Une moyenne nationale peut masquer une bonne performance dans les métropoles et une absence complète dans les communes secondaires. Les groupes géographiques rendent les décisions plus précises.
Les conversions locales incluent les appels, demandes d’itinéraire, réservations, formulaires et visites de pages pratiques. Leur attribution possède des limites, surtout lorsque l’utilisateur passe d’un appareil à un autre ou refuse certains traceurs. Les équipes peuvent travailler avec des tendances agrégées. La comparaison entre périodes similaires reste plus utile qu’une recherche artificielle de précision absolue.
Le suivi cartographique complète les positions traditionnelles. BrightLocal permet notamment d’observer une visibilité différente selon les points d’une grille. Un résultat favorable autour de l’établissement et faible en périphérie peut être cohérent avec la distance. L’analyse doit intégrer la concurrence, la densité urbaine et l’intention de la requête avant de recommander davantage de contenu.
Tester la visibilité dans les moteurs génératifs
Les réponses de ChatGPT, Gemini ou Perplexity peuvent citer des marques, des établissements et des documents. Leur comportement varie selon la formulation, le contexte et les fonctions de recherche disponibles. Un protocole reproductible utilise donc une liste fixe de requêtes, plusieurs catégories d’intention et un calendrier de test. Les résultats sont archivés avec les liens fournis.
Les requêtes peuvent porter sur un service dans une ville, une comparaison régionale ou une information pratique. Le test distingue la simple mention, la citation liée et l’exactitude du contenu repris. Une présence sans source exploitable ne possède pas la même valeur qu’une réponse orientant vers la page officielle. Les erreurs doivent être consignées séparément des absences.
L’analyse de données peut rapprocher les citations observées des caractéristiques éditoriales. Les pages souvent reprises possèdent parfois des titres précis, des tableaux lisibles ou des informations originales. Cette corrélation ne prouve pas un lien causal. Elle permet néanmoins de concevoir des tests contrôlés sur la structure, la fraîcheur et la densité documentaire.
Mettre à jour les pages selon leur niveau de risque
Toutes les informations ne vieillissent pas au même rythme. Une adresse reste souvent stable, alors qu’un horaire exceptionnel change rapidement. Les tarifs, événements, équipes et disponibilités suivent leur propre cycle. Le CMS peut attribuer une date de révision à chaque champ, au lieu d’imposer une réécriture complète selon une fréquence uniforme.
Un score de risque simple combine volatilité, impact utilisateur et dépendance externe. Les horaires d’un établissement obtiennent une priorité élevée, car une erreur peut provoquer un déplacement inutile. Un paragraphe historique reçoit une priorité plus faible. Les alertes sont dirigées vers le propriétaire de la donnée, qui confirme ou corrige l’information.
- Taux de pages locales indexées et accessibles.
- Impressions issues de requêtes comprenant un territoire.
- Actions locales attribuables aux pages publiées.
- Cohérence des adresses entre le site et les plateformes.
- Part des affirmations accompagnées d’une source valide.
- Présence et exactitude dans les réponses génératives testées.
- Délai moyen de correction après une modification opérationnelle.
Les expérimentations doivent modifier un élément à la fois lorsque cela reste possible. Une équipe peut comparer deux formats de bloc pratique sur des groupes de pages semblables. Elle observe ensuite les clics, les appels et les erreurs de compréhension. Changer simultanément le titre, le texte, les liens et les données structurées rend l’interprétation plus difficile.
Un tableau de bord utile sépare les indicateurs éditoriaux des mesures commerciales. Il affiche les pages sans source, les champs arrivant à échéance et les anomalies techniques. Une autre vue présente les impressions et conversions. Cette distinction empêche une hausse de trafic de masquer une dégradation de l’exactitude locale.
La mesure sert également à réduire la production inutile. Une zone sans activité réelle ne justifie pas automatiquement une page optimisée. Les données de demande, les capacités de service et les résultats obtenus orientent les priorités. Le programme éditorial peut alors renforcer les territoires utiles, fusionner des contenus faibles ou retirer les pages devenues obsolètes.
On en dit Quoi ?
Les outils IA accélèrent nettement la création et la diffusion de pages locales lorsque les données sont déjà structurées. Leur valeur repose surtout sur l’orchestration : un référentiel pour les faits, des sources contrôlées, un modèle pour la rédaction, un CMS pour les versions et des indicateurs pour détecter les écarts. L’automatisation devient pertinente quand elle réduit les tâches répétitives sans autoriser la publication d’informations locales invérifiables.
Quel outil IA choisir pour rédiger des contenus géolocalisés ?
ChatGPT et Gemini conviennent à la génération de brouillons structurés. Perplexity facilite la recherche documentaire, tandis que DeepL aide à adapter les variantes linguistiques. Le choix dépend du CMS, des langues traitées et du niveau de contrôle attendu.
Comment éviter les pages locales presque identiques ?
Chaque page doit utiliser des données propres au territoire : services disponibles, accès, horaires, contraintes, modalités de livraison et sources locales. Un contrôle de similarité permet de repérer les blocs où seul le nom de la ville change.
Les données structurées améliorent-elles automatiquement le classement ?
Les données structurées aident les machines à interpréter une adresse, un établissement ou des coordonnées. Elles ne garantissent pas une meilleure position. Leur contenu doit correspondre aux informations visibles et rester exact.
Peut-on publier automatiquement les textes produits par intelligence artificielle ?
Une automatisation complète présente des risques factuels, juridiques et éditoriaux. Un circuit fiable impose une validation humaine pour les adresses, horaires, tarifs, sources et mentions réglementaires avant la mise en ligne.
Comment mesurer la visibilité dans les moteurs génératifs ?
Il faut préparer un ensemble stable de requêtes locales, répéter les tests dans des conditions comparables et enregistrer les mentions, citations, liens et erreurs. Ces observations complètent les données SEO traditionnelles sans les remplacer.
Articles liés
IA
À Singapour, une tour de contrôle révolutionnaire supervise l’IA dans les centres de données
Le 2 septembre 2026, l’AFP a documenté à Singapour un centre de commandement surveillant plus de 300 centres de données.…
IA
Anthropic révolutionne Claude Code en un orchestrateur intelligent d’agents IA
Le 17 septembre 2026, Anthropic a annoncé une refonte de Claude Code centrée sur l’exécution parallèle de tâches logicielles. La…
IA
Infopro Digital Media lance GEO, une solution innovante pour ancrer les marques dans l’univers des IA génératives
Infopro Digital Media réunit 35 médias B2B couvrant notamment l’industrie, la construction, l’assurance, l’automobile et la distribution. La régie complète…